LapaLLM навчила 12-мільярдну модель української мови на базі Gemma
Волонтерський проєкт LapaLLM адаптував 12-мільярдну модель Gemma для української мови, відкрив датасети та створив лідерборд для оцінки LLM. Керівник проєкту Юрій Панів розповів про плани тренування більшої моделі на суперкомп'ютері JUPITER, відсутність закритих API-моделей у бенчмарках і потреби бізнесу та держави у власних мовних моделях.
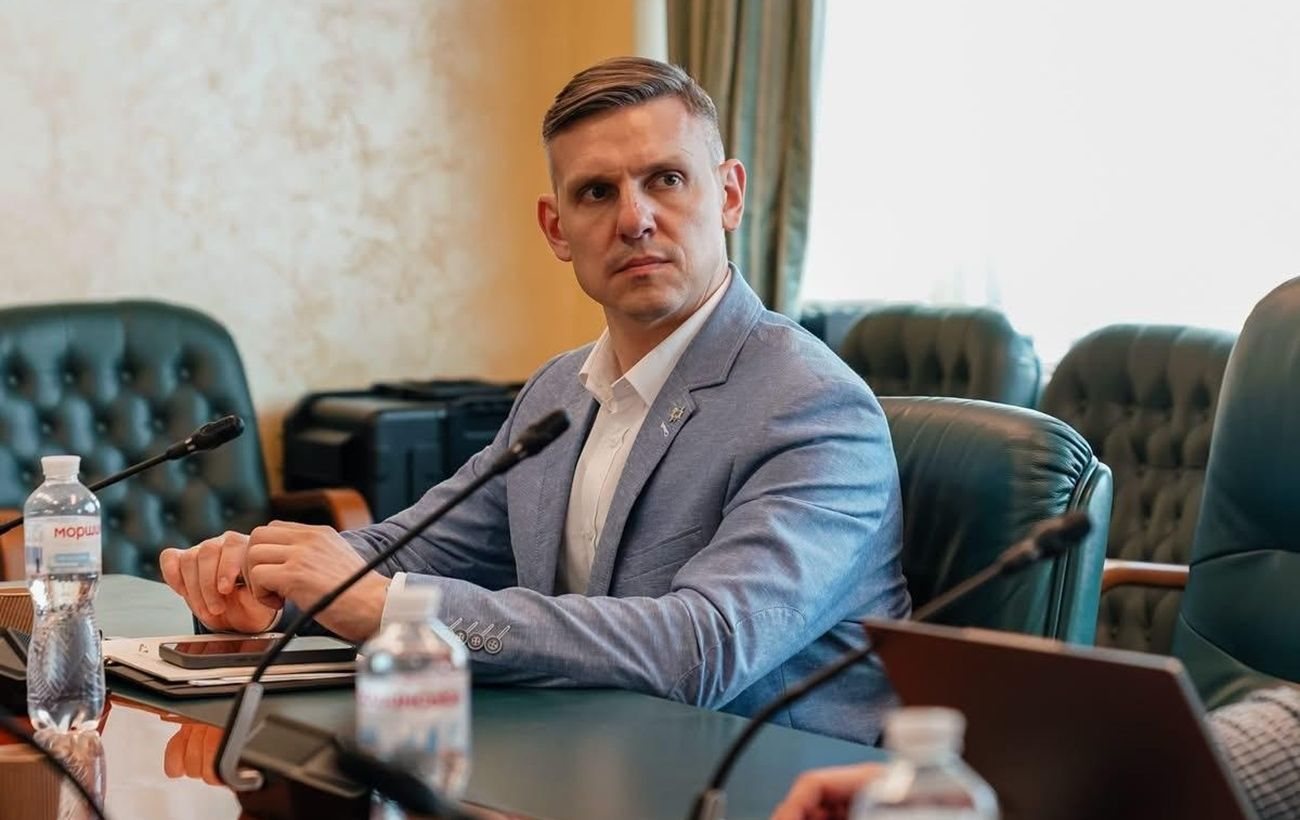
Волонтерська команда LapaLLM адаптувала 12-мільярдну велику мовну модель на базі Gemma для роботи з українською мовою. Про це в інтерв'ю розповів керівник проєкту та аспірант Українського католицького університету Юрій Панів. За його словами, проєкт залишається волонтерським, але команда вже шукає гранти для першої оплачуваної когорти дослідників українського NLP.
Історія LapaLLM сягає 2014 року, коли виникла потреба аналізувати великі масиви україномовних документів. Поштовхом став проєкт lang-uk, співзасновник якого Дмитро Чаплинський разом із журналістом-розслідувачем Денисом Бігусом створював сервіс для аналізу декларацій чиновників. Відтоді команда розробляє NLP-інструменти для української мови. Нині до LapaLLM залучено 13 осіб.
Наступний крок команди — тренування значно більшої моделі. За основу взято Mistral Small, 120-мільярдну модель типу Mixture of Experts. Для цього LapaLLM подалася на програму EuroHPC, яка надає дослідникам і бізнесу безплатний доступ до потужних обчислювальних ресурсів. Команда отримала доступ до суперкомп'ютера JUPITER із відеокартами GH200, кожна з яких має близько 120 ГБ відеопам'яті. Йдеться про 5000 нод-годин на ноді з чотирма картками.
За словами Панева, до українських суперкомп'ютерів команда доступу не має. Зараз триває розробницький етап: готуються всі скрипти, щоб згодом запустити повноцінне тренування більшої моделі. На основі отриманих результатів LapaLLM планує подаватися на більший обсяг обчислень — хотілося б отримати мільйони нод-годин і мати найбільший обчислювальний ресурс в Україні для тренування такої великої моделі.
Окремий напрям роботи — лідерборд для оцінки LLM з українською мовою. У ньому немає закритих API-рішень, зокрема продуктів Anthropic. Причина суто фінансова: щоб прогнати бенчмарки, потрібно дуже багато промптів і кілька прогонів, а орієнтовна вартість одного прогону лише для однієї API-моделі становить близько 400–500 доларів. Якщо знайдеться потенційний спонсор, команда готова додати великий банер на лідерборді про підтримку та протестувати відповідну модель.
Після отримання гранту LapaLLM планує прогнати бенчмарки для більшості наявних моделей — до трьох трильйонів параметрів, зокрема Kimi K2 та інших китайських моделей. Поки що більшість протестованих моделей не перевищують 30 мільярдів параметрів. Водночас, судячи з відгуків, 12-мільярдні моделі вже сприймаються як недостатньо серйозні — потрібно щось більше.
Юрій Панів наголошує, що найбільший результат лідерборду — можливість побачити, які моделі найкраще, а які найгірше працюють з українською мовою, і знайти відповідні датасети. Більшість даних для тренування відкрито, код теж відкритий, тож інші дослідники можуть використати їх і самостійно відтворити тренування.
Потреба у власній українській LLM має кілька вимірів. Перший — продуктивність: користувачі помічають перекладені калькою терміни й гіршу якість українською порівняно з англійською. Другий — приватність: можливість запустити модель на своєму залізі, у безпечному закритому контурі. Це стосується обробки сенситивних даних, державних юзкейсів із документами або військових задач. Поступово ця потреба наростає, і бізнес чи науковці мають розуміти, яка з наявних моделей найкраще підходить для конкретної задачі та є найбезпечнішою.
Окремо Панів згадує менш прагматичний мотив — мати таку експертизу в Україні. За його словами, моделі приходять і йдуть, а датасет залишається. Саме тому команда зосереджується на відкритості даних і коду, аби напрацювання LapaLLM могли використовувати й розвивати інші дослідники.
5